
Colonel Clustered:基于内容相似度的 Burp Suite 响应聚类扩展,模糊测试异常值一眼锁定
做渗透测试的朋友对 Burp Intruder 一定不陌生:跑完一轮模糊测试后,面对成百上千条响应,我们习惯按状态码、响应时间和响应长度排序,试图从中找出"不对劲"的那几条。问题是,这些都是响应内容的间接指标——如果某个输入触发的差异既不改变状态码、也不改变响应大小,它就会在 Intruder 的结果列表里完美隐身。
Colonel Clustered 正是为解决这个痛点而生的 Burp Suite 扩展。它基于文本聚类算法分析 HTTP 响应的实际内容,按相似度自动分组,让渗透测试人员在 Intruder 模糊测试后能够快速发现内容异常的服务器响应,而不必人工逐条翻阅数千条结果。
产品介绍:为什么要对 HTTP 响应做聚类
Colonel Clustered 是安全研究员 hoodoer 开发的一款开源 Burp Suite 插件(当前版本 v1.0.1),核心思路很直接:状态码、响应时长、报文长度都无法刻画响应内容的相似程度,那就让算法替人"读"完所有响应,再按内容把它们归入不同的簇。内容相似的响应归为一组,落单的响应则集中进 "Outliers" 组,异常值由此浮出水面。
作者坦言这个插件的想法酝酿了很多年。Intruder 虽然完整记录了每一次响应,但人没有精力去比对数千条报文的细微差别;而文本聚类是学术界用了几十年的经典技术,K-Means 甚至可以追溯到上世纪五十年代——没有花哨的 LLM 魔法,只有扎实的数学。
Colonel Clustered 还巧妙地利用了 Intruder 结果的"批处理"特性:分析时整个数据集都在手边,算法可以自动校准自身参数,用户不需要调节任何设置,插件会根据数据特点自动完成拟合。
核心功能:双算法驱动的响应聚类
内容感知分词
扩展会先检查每条响应的 Content-Type 头,为不同类型的内容匹配最合适的分词策略:
| 内容类型 | 分词策略 |
|---|---|
| HTML | 剥离全部标签与脚本,对可见文本生成基于字符的 5-gram,并对数字做净化处理,使模板化内容中的 ID 等细微变化不影响相似度判断 |
| JSON | 提取所有键名及其嵌套路径作为 token,忽略具体取值;数组则分析其中所有对象的结构 |
| 纯文本 | 生成基于字符的 5-gram,同样对数字做净化以增强模板鲁棒性 |
| 二进制/其他 | 生成一组 5 字节 n-gram,在非文本数据中查找相似性 |
预分组加速
面对数千条响应,插件会先做一次快速遍历:计算每条响应 token 集合的哈希值,把哈希相同的项归为同组。这样,真正昂贵的聚类计算只在一个规模小得多的"唯一响应正文"集合上运行,大幅降低了计算量。
快速扫描(默认算法)
向扩展发送多条请求/响应后,会自动运行一套高性能的 DBSCAN 聚类算法:
- Epsilon 自动调优:借助 Kneedle 算法自动确定最优 epsilon(密度半径),适应不同数据集的分布特征;
- 敏感异常值检测(minPts=2):minPts 固定为 2,能精准识别完全唯一的响应,或只与另一条响应存在相似性的响应。
深度分析(手动触发)
当快速扫描的分组结果不够理想时,可点击 "Deep Analysis" 按钮启动计算量更大的层次聚类算法:
- 基于唯一响应之间的 Jaccard 距离构建相似度矩阵;
- 采用 Average Linkage 逐步合并最相似的簇,同时记录合并距离以确定最优阈值;
- 聚类完成后,只包含单个唯一成员的组会被判定为异常值,并在 UI 中统一合并进 "Outliers" 组。
技术优势:不止于"按长度排序"
与 Intruder 默认的排序、过滤方式相比,这套内容聚类方案有几个明显优势:
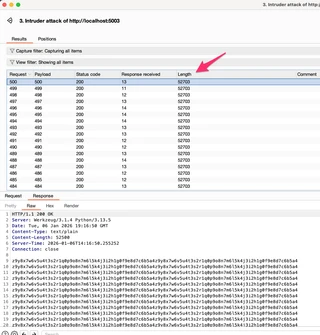
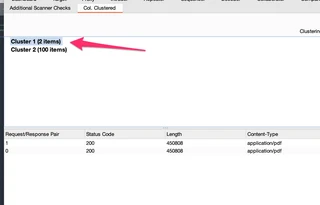
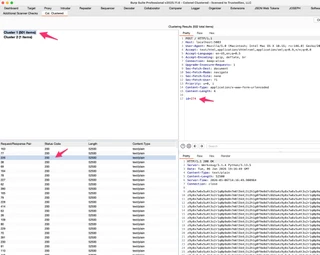
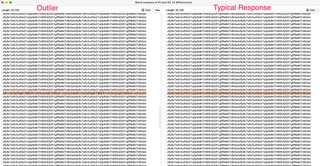
- 发现隐形差异:即使响应大小完全一致、状态码毫无变化,内容上的真实差异也会被聚类暴露出来。作者给出的"大海捞针"示例中,数百条响应长度全部为 52700 字节,仅因一个 ID 值导致某条响应中的一行内容不同——不靠聚类几乎不可能找到。
- 零参数配置:利用 Intruder 结果的批量特性自动拟合参数,没有任何需要用户手动调节的旋钮,上手即用。
- 双重算法互补:快速扫描覆盖绝大多数日常场景,深度分析在快速算法分组不理想时提供更细粒度、可能截然不同的聚类视角,两者都能随时取消。
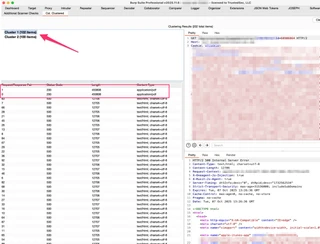
- 四窗格结果界面:分析结果以四窗格布局呈现——左上为簇列表(含特殊的 "Outliers" 组,标注每组项数),左下为簇成员表格(包含 Request/Response Pair、Status Code、Length、Content-Type 四列,点击列头可排序),右侧上下两个窗格用于查看选中项的完整请求与响应。
需要留意的是性能边界:快速算法的时间复杂度为 O(n²),深度分析算法为 O(n³)。作者不建议向插件投喂 5 万条响应;对大规模数据集,深度分析在开始前也会弹出性能警告。
使用方式:从安装到分析只需四步
1. 加载扩展
在 Burp Suite 中进入 **Extensions 选项卡,点击 Add**,选择 ColonelClustered.jar 文件。加载成功后界面会出现一个名为 "Col. Clustered" 的新选项卡。该扩展已提交至 BAPP 商店审核,获批后可直接从商店安装。
2. 发送响应进行分析
在 Intruder 结果或 Proxy 历史等任意工具中,选中一条或多条请求/响应,右键选择 **"Send to Colonel Clustered"**。默认的快速扫描会自动开始,进度条可实时查看分析进度。
3. 执行深度分析(可选)
如需更精细的层次聚类结果,点击 **"Deep Analysis"** 按钮即可。分析项数较多时,扫描开始前会提示潜在的性能问题。
4. 在四窗格界面中分析结果
在簇列表中选择分组,查看成员表格,点击列头排序以快速定位最大/最小响应或按状态码归类,再在右侧查看器中审阅完整的请求与响应内容。
从源码构建
项目使用 Gradle 构建,需要 JDK 17:
git clone <repository-url>
cd ColonelClustered
./gradlew build
编译完成后,JAR 文件位于 build/libs/ColonelClustered.jar。
应用场景:这些时刻它特别管用
- 目录与参数模糊测试:对大量路径、ID 参数进行爆破时,绝大多数响应内容雷同,少数内容不同的响应往往意味着隐藏端点、越权数据或未处理的错误分支。
- 枚举类攻击结果分析:用户枚举、IDOR 探测等场景中,正常响应与异常响应常常共享相同的长度和状态码,靠传统排序手段无从分辨。
- 大报文差异定位:响应体庞大且高度模板化时(如 JSON 数组、加密内容),聚类配合 Burp Comparer 可以快速锁定差异行,把"大海捞针"变成点击几下的事。
总结
Colonel Clustered 用经典的文本聚类技术填补了一个长期存在的分析盲区:当响应大小不再是差异的可靠度量时,内容相似度聚类让异常值自动现形。它没有复杂的配置项,加载 JAR、右键发送、查看分组,三步就能融入现有的 Burp 渗透测试工作流,是 Intruder 模糊测试结果的强力补充分析工具。